
Descargar esta infografía (PNG)
Resumen
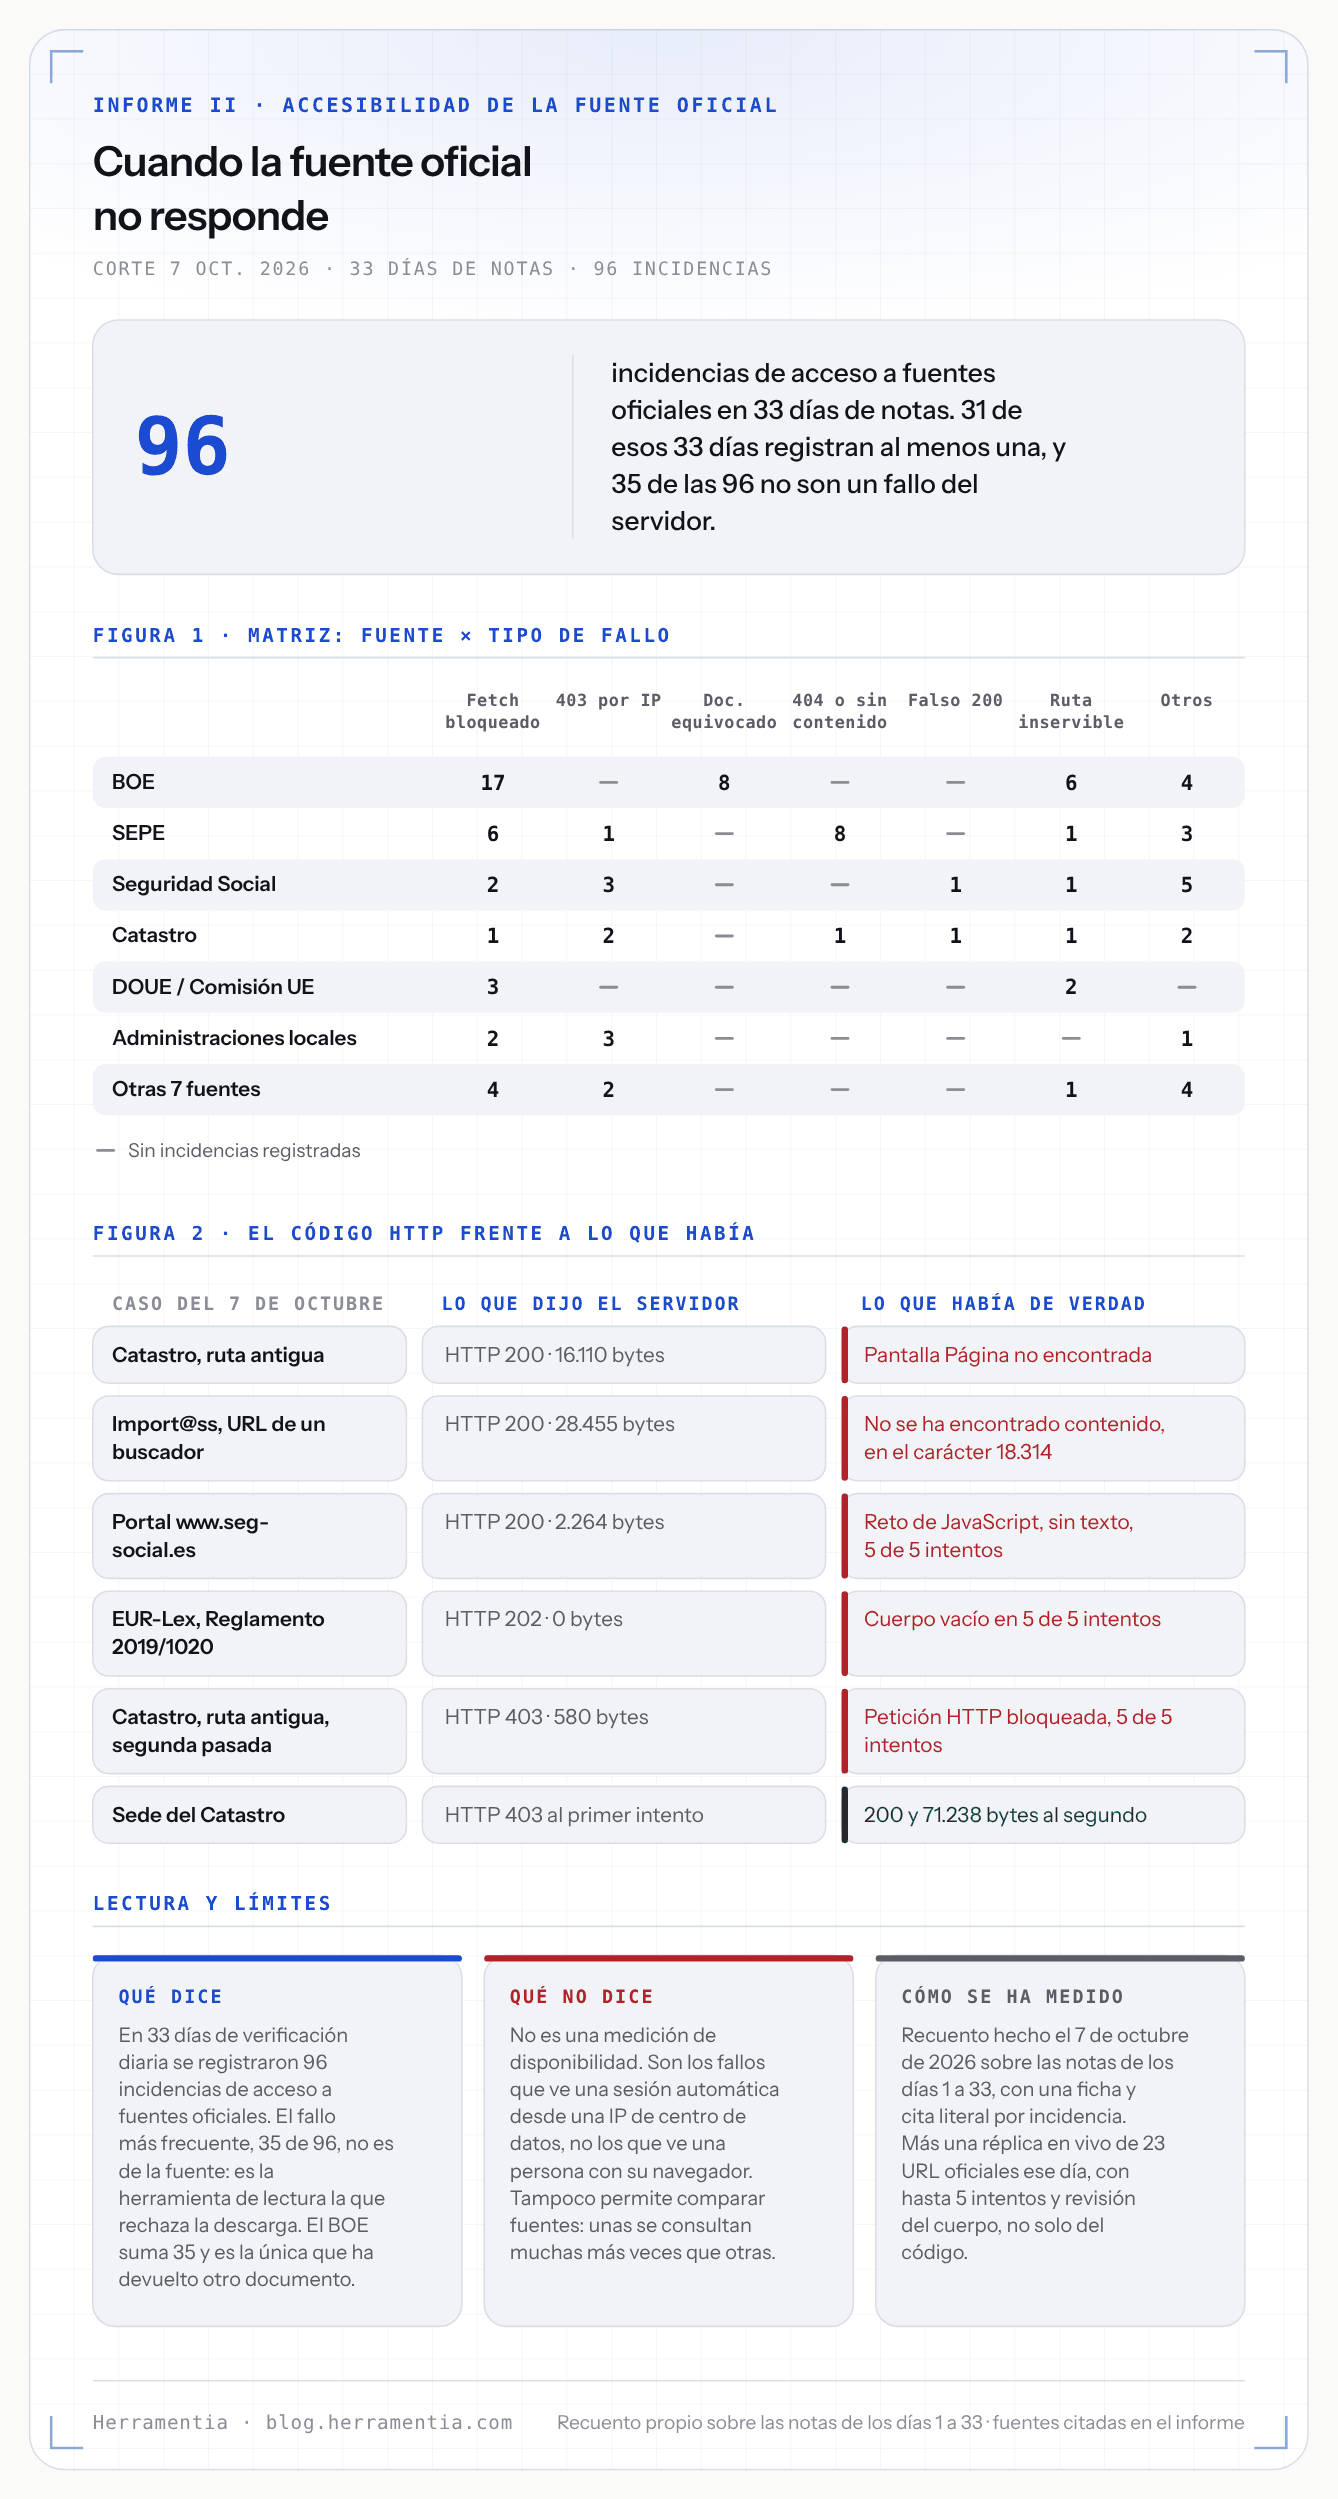
Entre el 2 de septiembre y el 6 de octubre de 2026 publicamos 33 entradas en este blog con una regla fija: ningún dato normativo se escribe sin haberlo leído ese mismo día en su fuente primaria. Esa regla deja un subproducto: un registro de qué pasa cuando se intenta llegar al texto oficial. El 7 de octubre de 2026 hemos recontado ese registro. Resultado: 96 incidencias de acceso a fuentes oficiales en 33 días, con al menos una en 31 de esos 33 días. El BOE acumula 35, el SEPE 19, la Seguridad Social 12 y el Catastro 8. El fallo más repetido, 35 de 96, no lo provoca el servidor: lo provoca la herramienta de lectura, que rechaza la descarga antes de llegar a la fuente. Y el más peligroso no se ve: páginas de error servidas con código HTTP 200.
La pregunta que responde este informe
La pregunta es estrecha a propósito: al verificar una guía, ¿con qué frecuencia y de qué modo falla el acceso a las fuentes oficiales?
No es «¿están caídas las webs de la Administración?». Eso exigiría una medición de disponibilidad desde varios puntos y durante meses, y no es lo que tenemos. Lo que tenemos es un registro de trabajo: cada día, una sesión automática intenta leer los artículos, órdenes y páginas oficiales que una guía necesita, y anota lo que ocurre. Al cabo de 33 días, ese registro admite un recuento.
Conviene decirlo antes de empezar: Herramentia es parte interesada. El registro es nuestro, el criterio de clasificación es nuestro, y un informe que diga «llegar a la fuente oficial cuesta» justifica el trabajo de verificación que presentamos como señal de calidad. Por eso el método está abajo entero, y por eso buena parte de los hallazgos van contra nosotros: más de un tercio de los fallos no son de la Administración, sino de nuestras propias herramientas de lectura.
Este es el segundo informe de la serie. El primero, «La brecha documental», midió la distancia entre lo que dice la norma y lo que se publica sobre ella, y dedicó un apartado corto a la accesibilidad de la fuente. Aquello eran observaciones sueltas; esto es el recuento.
Método y fecha de corte
Fecha de corte: 7 de octubre de 2026. Todas las cifras de este informe se han producido ese día. Ninguna viene de memoria ni de un recuento anterior.
El material son las notas de verificación de las entradas 1 a 33 del blog. Las de los días 9 a 33 viven en un documento por día; las de los días 1 a 8 están dentro del calendario editorial, porque hasta el día 9 las notas se escribían ahí. Son 33 días con registro, del 2 de septiembre al 6 de octubre de 2026.
El procedimiento. Primero, releer los 33 registros y abrir una ficha por incidencia, con el día, la fuente, la URL cuando la nota la da, el tipo de fallo, la herramienta con la que se pidió y una cita literal que sostiene la ficha. Si la nota no dice algo, el campo queda en «desconocido»: no se deduce.
Segundo, aplicar dos filtros. Uno de alcance: se cuentan solo las fuentes oficiales (BOE, SEPE, Catastro, Seguridad Social, AEPD, CENDOJ, ministerios, administraciones autonómicas y locales, Diario Oficial de la Unión Europea y equivalentes extranjeros); las fuentes privadas dejaron 46 incidencias más que quedan fuera de las 96. Otro de deduplicación: para los días 1 a 8 vale el calendario y para los días 9 a 33, el fichero de notas del día, porque el calendario también resume los días 9 a 30 y contar las dos versiones habría inflado el total. Son 39 filas duplicadas descartadas expresamente.
Tercero, clasificar cada ficha en una lista cerrada de tipos de fallo, fijada antes de contar:
- Fetch bloqueado: la herramienta de lectura rechaza la petición antes de entregar nada (
PROVENANCE_REQUIRED,ROBOTS_DISALLOWEDy similares). El servidor puede estar perfectamente. - 403 por IP: el servidor rechaza la petición por venir de donde viene.
- Documento equivocado: la fuente responde bien y entrega un documento distinto del pedido.
- 404 o sin contenido: no hay documento, o lo hay pero la página no lo contiene.
- Falso 200: página de error servida con código de éxito.
- Ruta inservible: la URL responde 200 pero no entrega lo que se busca (el articulado se corta, solo hay considerandos, solo llega el cascarón de la página).
- Otros: bucles de redirección, cuerpos vacíos, URL movidas sin redirección, mantenimiento y cautelas de acceso declaradas que no encajan en los anteriores.
Y cuarto, una réplica en vivo el mismo 7 de octubre: 23 URL oficiales, hasta cinco intentos cada una, pausa de diez segundos y revisión del cuerpo de la respuesta, no solo del código. Son 36 peticiones HTTP, y sirven para contrastar el registro acumulado con una medición homogénea hecha de una vez.
Resultados
96 incidencias y 31 días de 33
El recuento da 96 incidencias de acceso a fuentes oficiales repartidas en 33 días. Solo dos días no registran ninguna: el día 1 y el día 27. La media es de 2,91 incidencias por día y el máximo está en el día 11, con nueve.
Ese 31 de 33 es la cifra que mejor resume el informe, y conviene leerla con cuidado. No dice que las webs oficiales estén caídas casi todos los días. Dice que casi cualquier jornada de trabajo contra fuente primaria se topa con al menos un obstáculo de acceso. La mayoría se resuelven el mismo día cambiando de ruta, de herramienta o reintentando. Pero se resuelven porque alguien los ve.
Dónde se concentran
El reparto por fuente es desigual:
| Fuente | Incidencias | Parte del total |
|---|---|---|
| BOE | 35 | 36 % |
| SEPE | 19 | 20 % |
| Seguridad Social | 12 | 13 % |
| Catastro | 8 | 8 % |
| DOUE y Comisión Europea | 5 | 5 % |
| Administraciones autonómicas y locales | 6 | 6 % |
| Otras siete fuentes oficiales | 11 | 11 % |
| Total | 96 | 100 % |
Las «otras siete» son el CENDOJ, el MITECO, el Ministerio de Trabajo, el Ministerio de Hacienda, el Parlamento Europeo, Légifrance y el FBI, cada una con una o dos incidencias.
Esta tabla no mide fiabilidad comparada, y es importante no leerla así. El BOE encabeza la lista porque es la fuente que más veces se consulta: casi toda guía acaba en un artículo suyo. Una fuente que se pide cien veces y falla treinta y cinco no es peor que una que se pide tres y falla una. Las notas registran los fallos, no los intentos, así que no podemos dar tasas por fuente, solo recuentos absolutos.
El tipo de fallo que más se repite no es culpa de la fuente
Este es el hallazgo que más nos ha sorprendido al contar.
| Tipo de fallo | Casos |
|---|---|
| Fetch bloqueado (lo rechaza nuestra herramienta) | 35 |
| Otros (redirecciones, cuerpos vacíos, URL movidas, mantenimiento) | 19 |
| Ruta inservible (responde, pero no entrega el texto) | 12 |
| 403 por IP | 11 |
| 404 o sin contenido | 9 |
| Documento equivocado | 8 |
| Falso 200 | 2 |
| Total | 96 |
35 de las 96 incidencias (36 %) no son un fallo del servidor oficial. Son peticiones que nuestra propia herramienta de lectura rechazó antes de salir: avisos del tipo PROVENANCE_REQUIRED o ROBOTS_DISALLOWED. De esas 35, en 28 casos la nota identifica expresamente la herramienta que rechazó. Los días siguientes, muchas de esas mismas URL se descargaron sin problema con curl y un User-Agent de navegador.
El ejemplo más claro es el del día 28. Durante semanas dimos por imposible leer el articulado completo de un reglamento europeo; aquel día resultó que el PDF del Diario Oficial que publica el propio BOE se descarga entero a la primera. La nota lo resume sin adornos: el problema era el intermediario, no el documento. Lo mismo con la Seguridad Social, cuyo portal se dio por bloqueado el día 26 y respondió a la primera el día 33.
Si este informe tiene una consecuencia práctica inmediata para nosotros, es esa: una parte sustancial de lo que llevábamos un mes anotando como «la fuente oficial no responde» era en realidad «no la hemos pedido bien». Lo escribimos aquí porque el informe que solo mide errores ajenos no merece crédito.
El BOE: nunca bloquea, pero es el único que entrega otro documento
El perfil del BOE es peculiar. De sus 35 incidencias, 17 son fetch bloqueado, 6 son rutas que responden pero no entregan el texto, 4 caen en «otros» y 8 son documentos equivocados. No tiene ni un 403 por IP ni un falso 200 registrado: cuando el BOE deja pasar, deja pasar.
Los ocho documentos equivocados son el patrón más incómodo de todo el corpus, porque la respuesta parece correcta. Algunos ejemplos literales de las notas:
- Día 10: «tanto
act.php?id=BOE-A-2015-10565comodoc.php?id=BOE-A-2015-10565(Ley 39/2015) devolvieron el RD 1044/1985». - Día 15: «al pedir
act.phpcon BOE-A-2015-11723, el BOE devolvió el RD 390/2021, otro documento distinto». - Día 22: «
act.phpcon BOE-A-1996-3607 devuelve una resolución de la Federación Española de Colombicultura, no el RD 84/1996». - Día 23: «BOE-A-2025-11607 devolvió una resolución sobre violencia de género, no la orden buscada».
De ahí la regla que seguimos desde entonces: comprobar siempre el <title> de la descarga antes de citar nada. Un identificador mal deducido —y los del BOE no se deducen de la numeración de la norma— no da error: da otra norma, coherente, verosímil y equivocada.
El segundo patrón del BOE son las rutas que responden pero no sirven: la versión consolidada que se corta antes de los anexos en las leyes largas (día 19: «la página se corta antes de los anexos, termina en el artículo 19»), la ruta ELI que devuelve solo el cascarón (día 30), o el reglamento europeo del que llegan los considerandos y no el articulado (días 8 y 17).
El falso 200: el fallo que ningún comprobador detecta
Solo hay dos falsos 200 en las 96 fichas, y sin embargo creemos que es el hallazgo más importante del informe. Por dos razones.
La primera: aparecieron en dos días seguidos y en dos portales distintos. El día 32, las direcciones antiguas del Catastro —el portal migró de /esp/*.asp a /es-ES/*.html— «no devuelven 404: devuelven HTTP 200 con una pantalla de “Portal del Catastro: Página no encontrada” de 16.110 bytes». El día 33, una URL de Import@ss tomada de un buscador «devuelve HTTP 200 con un cuerpo que dice “No se ha encontrado contenido para: importass_contenidos/categorias/…”». Dos administraciones sin relación entre sí, el mismo comportamiento.
La segunda: un comprobador de enlaces no los ve. Un enlace roto que devuelve 200 figura como sano en cualquier auditoría automática y sigue llevando al lector a una pantalla de error.
Que haya solo dos fichas no significa que sea raro, sino que solo se detecta mirando el cuerpo de la respuesta, y eso no se hacía de forma sistemática los primeros treinta días. La réplica del 7 de octubre, ya con esa comprobación, encontró dos falsos 200 en 23 URL.
Hay una variante igual de engañosa en sentido contrario: el 404 con cuerpo grande. Tres fichas del SEPE registran rutas que devuelven 404 «con 73 KB de cascarón de cookies». Quien valide por tamaño de respuesta —y es una heurística común— dará por buena una página que no existe.
La réplica en vivo del 7 de octubre
El recuento anterior mezcla 33 días, varias herramientas y criterios que fueron cambiando. Para contrastarlo hicimos ese mismo día una medición homogénea: 23 URL oficiales, hasta cinco intentos por URL, 36 peticiones en total. Esto es lo que salió.
| Resultado | URL |
|---|---|
| Contenido útil al primer intento | 18 |
| Contenido útil tras reintentar | 1 |
| Falso 200 (código de éxito, página de error) | 2 |
| Sin contenido tras cinco intentos | 2 |
| Total | 23 |
Cuatro detalles merecen nombre propio.
El BOE pasó limpio, 7 de 7. Sus siete rutas —act.php, doc.php, ELI, PDF consolidado, diario_boe/txt.php y dos PDF del Diario Oficial— respondieron 200 al primer intento, con el documento correcto comprobado por su <title>. La fuente con más incidencias acumuladas tuvo un día perfecto; las tres URL del SEPE, también.
El Catastro da los dos problemas del día 32 a la vez. La dirección antigua /esp/procedimientos_tramites.asp devolvió, en una primera pasada, 200 con 16.110 bytes de página de error, y en una segunda, 403 «Petición HTTP bloqueada» en los cinco intentos: la misma URL, el mismo día, dos modos de fallo. La sede del Catastro dio 403 al primer intento y 200 con 71.238 bytes al segundo. La ruta nueva en /es-ES/*.html, en cambio, funciona.
Dos falsos 200 nuevos, de dos tipos distintos. Uno es el de Import@ss del día 33, que sigue igual: HTTP 200, 28.455 bytes, y el aviso de que no hay contenido escondido en el carácter 18.314 del cuerpo. Detalle que lo empeora: la URL buena y la mala tienen el mismo <title>, «Categorias», así que ni comprobar el título las distingue. El otro es nuevo: www.seg-social.es devolvió 200 con 2.264 bytes en los cinco intentos, y ese cuerpo no es una página: es un reto de JavaScript, sin una sola línea de texto legible. Un 200 que no contiene nada.
Un código que no es un error y tampoco sirve. EUR-Lex respondió HTTP 202 con cero bytes en los cinco intentos. El 202 significa «aceptado, se procesará»; para quien necesita el texto de un reglamento, equivale a nada.
¿Está mejorando?
Repartiendo los 33 días en tres tramos, las incidencias bajan: 41 en los días 1 a 11, 32 en los días 12 a 22 y 23 en los días 23 a 33.
La tentación es leerlo como que las fuentes oficiales han mejorado. No se puede concluir eso. En esos mismos días cambió nuestro método: desde el día 24 se abandonó casi del todo la lectura resumida y se pasó a descargar con curl. Como el fallo más frecuente es justo el que provoca la herramienta de lectura, la caída del total es compatible con que nada haya cambiado en el lado de la Administración. Lo más probable es que haya mejorado el método, y el dato no permite separar las dos cosas.
Qué significa esto
Tres lecturas, por orden de solidez.
Primera: verificar contra fuente primaria cuesta más de lo que parece, y el coste no está donde se cree. No está en entender el artículo; está en llegar a él. Treinta y una de treinta y tres jornadas tuvieron algún obstáculo de acceso. Quien publique información administrativa y no presupueste ese coste acabará copiando de una fuente secundaria, y el Informe I contó lo que pasa entonces: 76 discrepancias en 27 guías.
Segunda: el modo de fallo peligroso no es la caída, es el éxito falso. Una web caída se arregla: se ve, se reintenta, se busca otra ruta. Un 200 que devuelve una página de error, un 404 con 73 KB de cascarón o un identificador que entrega otra norma no se ven. Son los que terminan en una cita errónea publicada. De los siete tipos que hemos clasificado, los tres que no avisan —documento equivocado, falso 200 y ruta inservible— suman 22 de las 96 incidencias, casi una cuarta parte.
Tercera, y va contra nosotros: antes de culpar a la fuente, hay que probar otra vía. Treinta y cinco de noventa y seis fallos eran del intermediario. Dos cautelas que mantuvimos durante semanas —el reglamento europeo inalcanzable, el portal de la Seguridad Social bloqueado— resultaron falsas en cuanto se cambió de herramienta. La regla operativa que sacamos, y que ya aplicamos, es sencilla: ninguna fuente se da por inalcanzable hasta haberla intentado con una descarga directa y un User-Agent de navegador, y ningún 403 cuenta como caída hasta haberlo reintentado cinco veces con pausa. La sede del Catastro del 7 de octubre, que pasó de 403 a 200 en el segundo intento, es el ejemplo del día.
Y una recomendación para quien publique páginas oficiales, la única que nos atrevemos a dar: cuando una URL deje de existir, devolver 404 o una redirección, nunca una página de error con código 200. El coste de no hacerlo lo paga, sin enterarse, todo el que haya enlazado a esa dirección.
Qué NO puede concluir este informe
Este apartado es más largo que el de resultados a propósito. Las cifras de arriba son fáciles de citar mal.
No es una medición de disponibilidad. No hay sondas, ni periodicidad fija, ni medición desde varios puntos de red. Son los fallos que encontró una sesión automática mientras hacía otra cosa. Decir «el BOE falló 35 veces en 33 días» sería tergiversar el dato: lo correcto es «al intentar leer el BOE desde esta sesión se registraron 35 incidencias en 33 días, la mayoría resueltas el mismo día».
No describe lo que ve una persona. Todas las peticiones salen de una IP de centro de datos, con herramientas automáticas, y los 403 por IP y los retos de JavaScript están diseñados para filtrar ese tráfico. Un ciudadano abriendo la misma URL en su navegador puede no ver ninguno de estos fallos.
No permite comparar fuentes entre sí. Falta el denominador. No sabemos cuántas veces se pidió cada fuente, así que el orden de la tabla refleja sobre todo cuánto usamos cada una. El BOE es el primero porque es el que más se consulta.
No dice nada de la calidad de la fuente cuando responde. Esto mide el acceso, no el contenido. Que el BOE entregue el texto consolidado no significa que el texto esté actualizado, y que una página del SEPE cargue no significa que explique bien el trámite. Eso es otro informe, y en parte es el Informe I.
La clasificación es nuestra y es discutible. Varias fichas podían encajar en dos tipos: un PROXY_REJECTED (HTTP 403) es a la vez rechazo de la herramienta y 403. Abrimos dos fichas cuando la nota describía dos fenómenos y una cuando describía uno visto de dos formas, pero otro criterio daría otro total. El 96 es sensible a esas decisiones en un margen que estimamos de unas diez fichas arriba o abajo.
El registro no es homogéneo en el tiempo. Las notas de los primeros días son menos detalladas, y el criterio de qué merecía anotarse fue cambiando. Hay subregistro casi seguro en los falsos 200, que solo empezamos a buscar desde el día 32.
«No se ha encontrado» no es «no existe». Varias fichas registran que una página oficial no documenta un procedimiento. Es el tipo de afirmación que más correcciones nos ha costado: el 4 de octubre dimos por inexistente un modelo del SEPE que sí existía. Aquí se registran como incidencia de acceso, no como prueba de inexistencia.
La muestra es pequeña y el periodo, corto. Treinta y tres días de un solo mes, en un idioma y sobre temas elegidos por demanda de búsqueda, no por sorteo. Una incidencia grande en un portal grande cambiaría la tabla entera.
Y Herramentia es parte interesada, como se dijo al principio: medimos nuestra propia dificultad para hacer nuestro propio trabajo, y el resultado nos favorece comercialmente. Lo contrapesamos publicando el método completo y los 35 fallos que son nuestros, pero no podemos eliminar el sesgo, solo declararlo.
Cómo reproducir esto
El recuento sobre notas no se puede reproducir desde fuera, porque las notas son internas. Lo decimos claro: esa mitad del informe hay que creérsela o no. Lo que sí publicamos es el procedimiento, por si alguien quiere aplicarlo a su propio registro: una ficha por incidencia con cita literal, lista cerrada de tipos fijada antes de contar, filtro de fuentes oficiales, regla de deduplicación declarada y campo «desconocido» cuando la nota no precisa.
La réplica en vivo sí es reproducible y no necesita nada especial. Para cada URL: descarga directa con un User-Agent de navegador, hasta cinco intentos con pausa, y tres comprobaciones sobre la respuesta, no sobre el código:
- El código HTTP, que es solo el primer filtro y el menos fiable.
- El
<title>, para detectar el documento equivocado y algunas páginas de error. No detecta el caso de Import@ss, donde la URL buena y la mala comparten título. - El cuerpo entero, buscando las frases de error del propio portal («Página no encontrada», «No se ha encontrado contenido»), el tamaño anómalo (2.264 bytes para una portada) y la ausencia de texto legible. Buscar solo en los primeros miles de caracteres no basta: en el caso de Import@ss el aviso está en el carácter 18.314.
Y una advertencia que nos costó un día entero: al descargar un fichero para analizarlo hay que comprobar el código y el tamaño igual que al verificarlo. Si no, lo que queda en disco es el cuerpo del error, y el análisis posterior concluye cualquier cosa.
Qué añade este informe al primero
El Informe I agrupó 76 discrepancias en cinco patrones de error sobre el contenido publicado, y trató el acceso a la fuente de pasada, sin cifras. Este no repite aquel hallazgo: lo cuantifica. Donde el primero decía «el BOE devolvió en varias ocasiones un documento distinto del solicitado», este dice que fueron ocho ocasiones, en qué días y qué norma llegó en su lugar. Y añade un patrón que el primero no tenía: el éxito falso.
Las guías que aportan material a este informe están publicadas: la del Catastro gratuito descubrió la migración de URL y el primer falso 200; la de la regularización de la cuota de autónomo, el segundo; la del precio de la nota simple es la que más veces volvió sobre la misma fuente; y la de los plazos del SEPE, donde empezó el patrón del 404 con cascarón de 73 KB.
Fuentes
Las fuentes de las cifras son dos, y las dos están descritas arriba: el registro interno de verificación de las entradas 1 a 33 de este blog, recontado el 7 de octubre de 2026, y la réplica de acceso en vivo hecha ese mismo día sobre 23 URL oficiales.
Los portales probados en la réplica, con su resultado en el cuerpo del informe: BOE (siete rutas), SEPE y su sede, Catastro y su sede, Import@ss y los portales de la Seguridad Social, el Ministerio de Justicia, la AEPD, el buscador del CGPJ, el MITECO y EUR-Lex.
Fuera del recuento quedan 46 incidencias más en fuentes no oficiales consultadas durante el mismo periodo —bases de datos jurídicas, portales de divulgación y prensa especializada—, encabezadas por los límites de acceso por IP de un par de bases de datos de pago. No se cuentan porque la pregunta del informe es sobre la fuente oficial, pero el dato está: casi un tercio de todos los obstáculos de acceso del mes vinieron de intermediarios privados, no de la Administración.
Lo que no hemos podido verificar
- Si estos fallos los ve un ciudadano. No hemos probado ninguna de estas URL desde una conexión doméstica con un navegador normal. Es la comprobación que más falta hace y no está hecha.
- Las causas. No sabemos por qué el BOE entrega a veces otro documento, ni qué sistema devuelve el 403 «Petición HTTP bloqueada» del Catastro, ni si el reto de JavaScript de
www.seg-social.eses permanente o de ese día. No hemos preguntado a ningún organismo. - Si hay política publicada sobre acceso automatizado. No hemos revisado los
robots.txtni las condiciones de uso de los portales probados, así que no decimos nada sobre si este tipo de acceso está permitido o desaconsejado en cada uno. - El número de intentos. Sin el denominador no hay tasas. Lo arreglaremos registrando también los accesos correctos a partir de ahora; hasta entonces, cualquier porcentaje de fallo por fuente que alguien calcule con estas cifras estará mal.
- La estabilidad de la réplica. Se hizo una sola vez, el 7 de octubre. Un día no es una serie.